RAG vettoriale contro GraphRAG
Un archivio di ticket di assistenza interrogabile in linguaggio naturale, costruito in due modi diversi e misurato con lo stesso metro: da una parte il knowledge graph del prototipo aziendale, dall'altra la baseline vettoriale che ho costruito io.
- Contesto
- Stage in APRA S.p.A.
- Stack
- Python · Qdrant · LangGraph · Docker
- Dati
- 1359 schede di ticket reali
- Stato
- Consegnato
Descrizione del progetto
Il supporto clienti di un gestionale riceve richieste via email. Ogni richiesta è un ticket: un thread che parte da un problema e finisce, quasi sempre, con una soluzione. Un modello linguistico ha distillato ogni thread in una scheda (problema, causa, soluzione), e le schede sono 1359.
Il prototipo aziendale trasforma quelle schede in un knowledge graph temporale: entità collegate da relazioni, dove ogni fatto ha una finestra di validità. Costruirlo costa, perché un modello deve leggere tutto l'archivio ed estrarne le entità. La domanda a cui serviva rispondere è se quel costo si ripaga: un RAG vettoriale fatto bene, che non costa niente da costruire, quanto ci va vicino?
Il mio lavoro è stato costruire quel termine di paragone e misurarlo. Una regola sopra tutte: il confronto deve isolare il retrieval, quindi stessi dati, stesso modello di generazione, stesso prompt, stesso benchmark e stessa forma di pipeline. L'unica cosa che cambia è il modo di trovare i documenti.
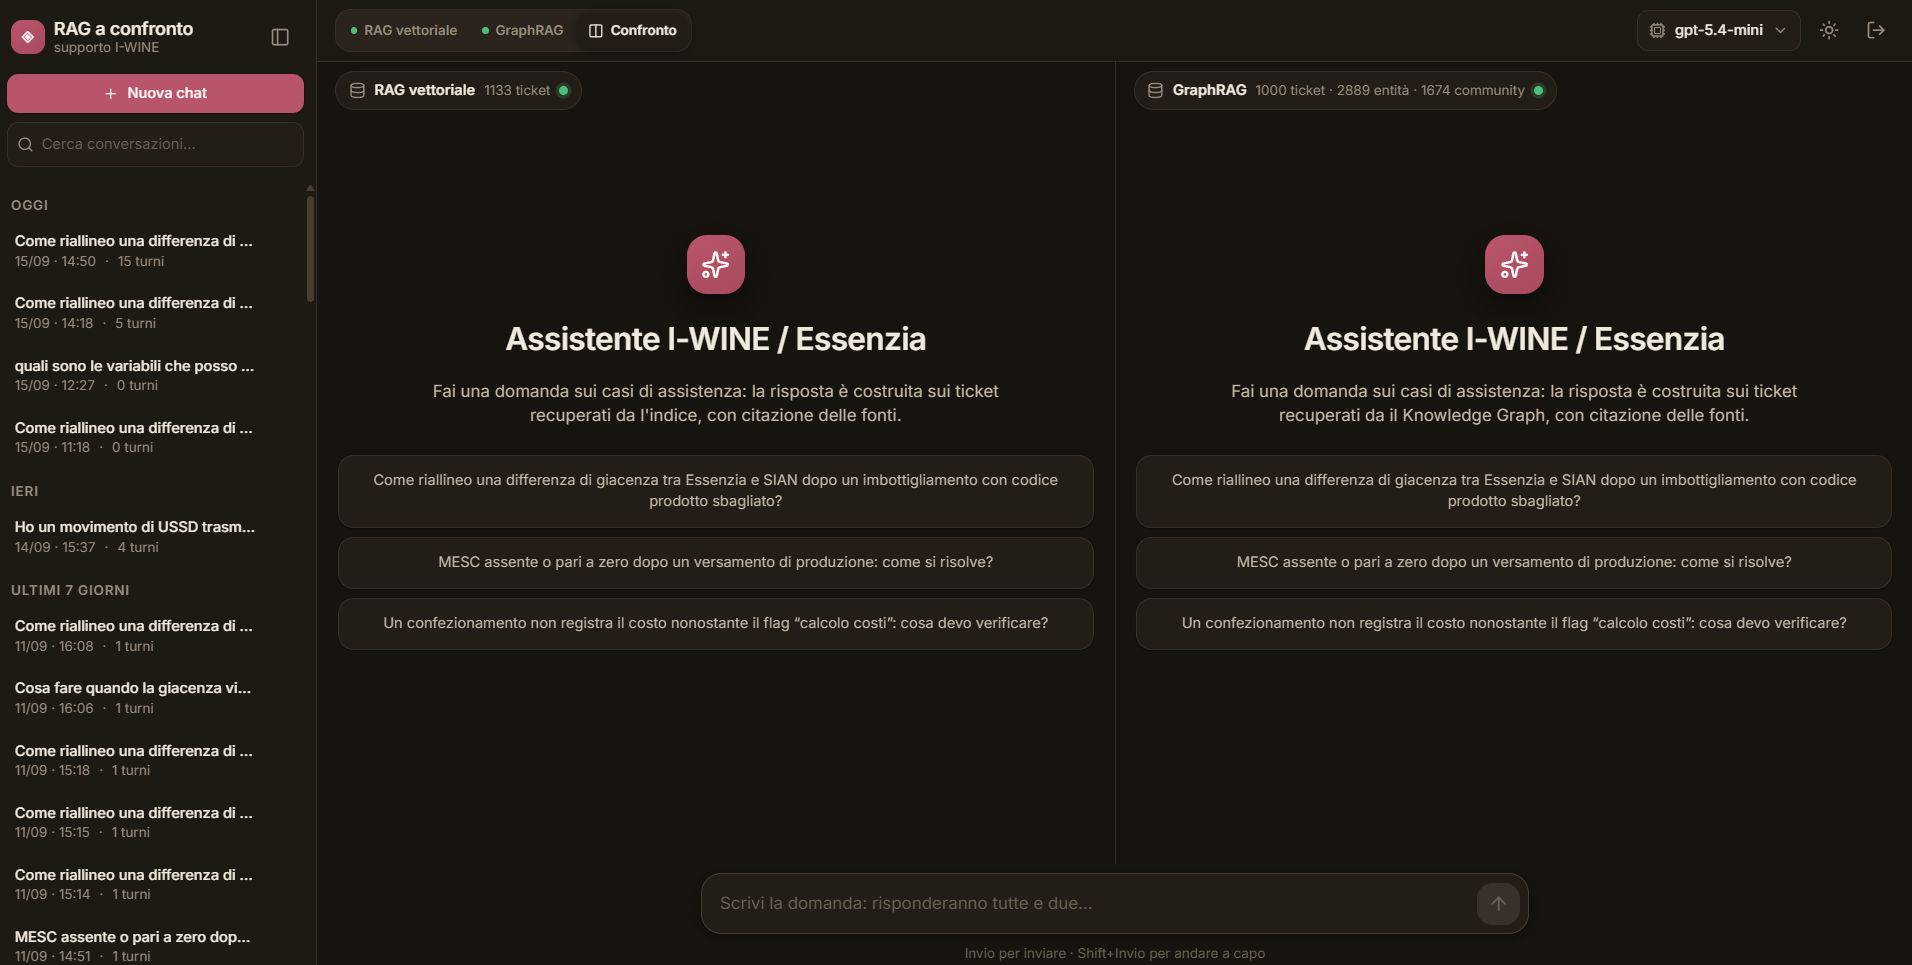
La stessa web app, con dentro tutte e due
Il frontend era quello del ragazzo che ha implementato il GraphRAG. Sopra quella web app ho implementato anche il RAG vettoriale, su richiesta del tutor della formazione scuola-lavoro, in modo da avere un confronto diretto dalla stessa interfaccia.
Giravano più container Docker, ognuno con il suo volume Docker: uno per Phoenix, uno per il RAG vettoriale e uno per il RAG a grafo. Il tutto era servito su una macchina di Hetzner, raggiungibile in HTTP su IP pubblico.
Tech stack
Tre vincoli hanno deciso quasi ogni scelta: i dati non escono dal computer, il confronto deve avvenire a parità di condizioni, e i testi sono in italiano e pieni di sigle di dominio. Il terzo è il più sottile: un modello semantico capisce che due frasi diverse dicono la stessa cosa, ma su un codice come R007 non ha niente da capire, o lo trova scritto uguale o non lo trova. Per questo il retrieval è ibrido e non solo vettoriale.
| Linguaggio | Python 3.13 |
|---|---|
| Database vettoriale | Qdrant 1.19, denso e sparso nella stessa collection |
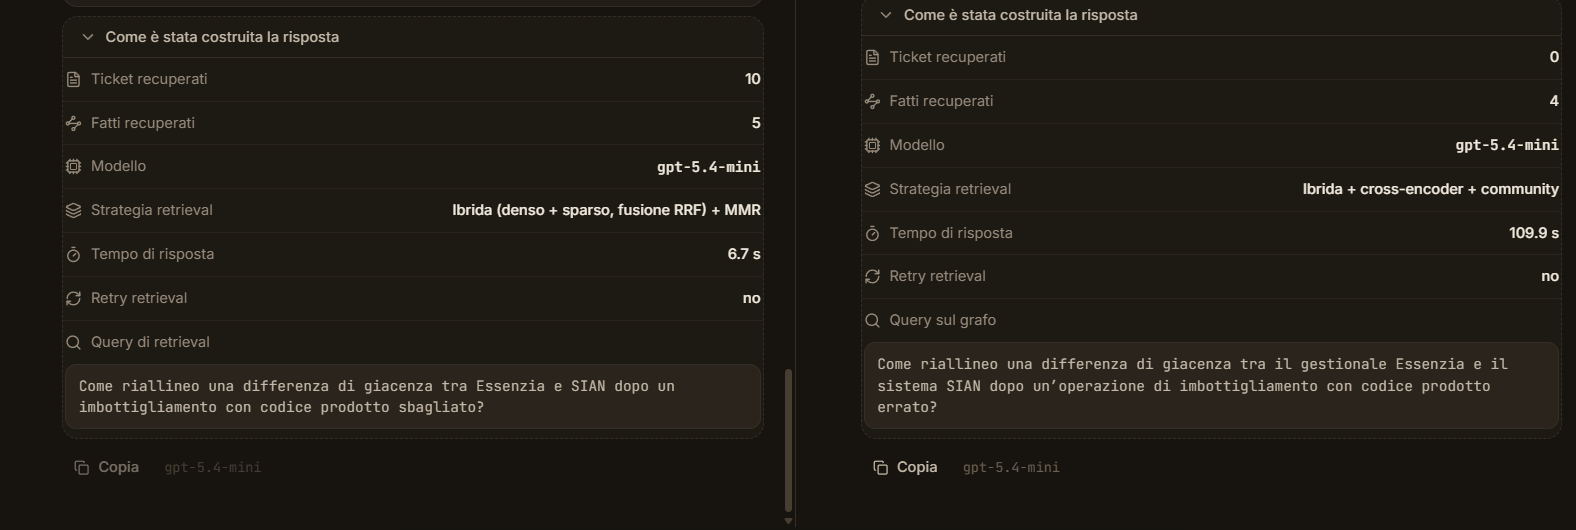
| Embedding | harrier-oss-v1-0.6b, 1024 dimensioni, finestra da 32.768 token, in locale |
| Ramo lessicale | BM25 italiano di FastEmbed, stemmer Snowball e stopword |
| Fusione | Reciprocal Rank Fusion lato server, più reranker cross-encoder e MMR |
| Pipeline | LangGraph: riscrittura della domanda, ricerca, giudizio di rilevanza, risposta |
| Osservabilità | Phoenix per tracce, costi e valutazioni |
| Interfaccia | Angular, già esistente, servita da nginx dentro il suo container |
| Infrastruttura | Docker Compose: Qdrant, backend vettoriale, backend a grafo, frontend |
La finestra da 32.768 token del modello di embedding non è un dettaglio di listino: le schede distillate ci stanno dentro intere, quindi non serve spezzarle in pezzi più piccoli. Una scheda è un documento, che è la baseline più pulita da mettere accanto al grafo.
I due ranking, quello semantico e quello lessicale, si uniscono guardando la posizione in classifica e non il punteggio: sulla stessa scheda il coseno vale 0,74 e BM25 vale 10,91, due numeri che non si possono sommare. Unire due classifiche invece si può, ed è quello che fa la fusione RRF, dentro il database e non nel nostro codice: meno codice nostro significa meno differenze fra le due pipeline che non siano il retrieval, che è proprio la cosa che l'esperimento vuole misurare.
Ogni passaggio della pipeline finisce dentro Phoenix: la traccia della singola domanda con i tempi di ciascun nodo, i token spesi, il costo in dollari e i giudizi del benchmark. Senza quel registro le misure della sezione qui sotto sarebbero racconti, e la latenza di un pezzo si potrebbe solo indovinare.
Problema risolto
Il problema a cui serve tutto questo è che la conoscenza dell'assistenza sta dentro migliaia di email, e chi ha davanti un caso nuovo non ha modo di sapere se qualcuno l'ha già risolto tre anni fa. Un archivio interrogabile a parole risponde a questo, e le risposte citano le schede da cui vengono.
Il problema che ho risolto io è un altro, ed è di metodo: sapere quanto valga davvero il grafo. Un'affermazione del tipo "il grafo funziona bene" non si può verificare senza un termine di paragone costruito con la stessa cura, sugli stessi dati e con lo stesso giudice. La baseline serve a quello, e il risultato è un numero per ogni domanda invece di un'impressione.
Un solo intoppo vero, ed è l'hardware: il modello di embedding gira in locale, quindi la macchina si sente, in indicizzazione e in risposta. Non è una scelta rinunciabile. Le schede contengono nomi, indirizzi e ragioni sociali di clienti reali, e mandarle a un servizio di embedding online significherebbe farle uscire dall'azienda. Girare in locale è la condizione che rende il progetto utilizzabile davvero, e il costo in prestazioni è il prezzo di quella condizione.
È stata la mia seconda esperienza in un ambito professionale all'interno di un'azienda, e ho imparato molto di come funziona un progetto reale, dove l'organizzazione è fondamentale: ho dovuto gestire varie cose contemporaneamente, e perdermi tra queste sarebbe stato un disastro e non mi avrebbe permesso di portare a termine in maniera efficace il progetto, soprattutto entro le poche settimane a disposizione.
I numeri
Stesso benchmark, stesse 32 domande, stesso modello di risposta, stesso giudice. Cambia solo il modo di trovare i documenti.
| Retrieval, almeno un documento giusto | 0,96 vettoriale · 0,37 grafo |
|---|---|
| Retrieval, quanti dei documenti giusti | 0,93 vettoriale · 0,31 grafo |
| Fedeltà della risposta al contesto | 0,97 vettoriale · 0,69 grafo |
| Correttezza della risposta | 0,75 vettoriale · 0,69 grafo |
| Robustezza temporale | solo il grafo, 1,00 |
| Tempo di una risposta | 6,7 secondi contro 109,9 |
- Il retrieval non è vicino, è un'altra scala — su 32 domande la baseline recupera almeno una scheda giusta in 31 casi, il grafo in 12. La differenza non è di rifinitura.
- La fedeltà segue il retrieval — 0,97 contro 0,69, con lo stesso modello e lo stesso prompt: quando nel contesto c'è davvero la scheda giusta, il modello non ha vuoti da riempire e smette di inventare.
- La correttezza si muove molto meno — 0,75 contro 0,69, cioè due domande su 32. Un guadagno enorme di retrieval si traduce in un guadagno modesto di risposta finale, ed è il risultato più interessante dei tre.
- Il grafo tiene una cosa che il vettoriale non può avere — la validità nel tempo. Segnalare che una soluzione è stata superata da una successiva è fuori dalla portata di un indice di vettori, e su un archivio che invecchia non è un dettaglio.
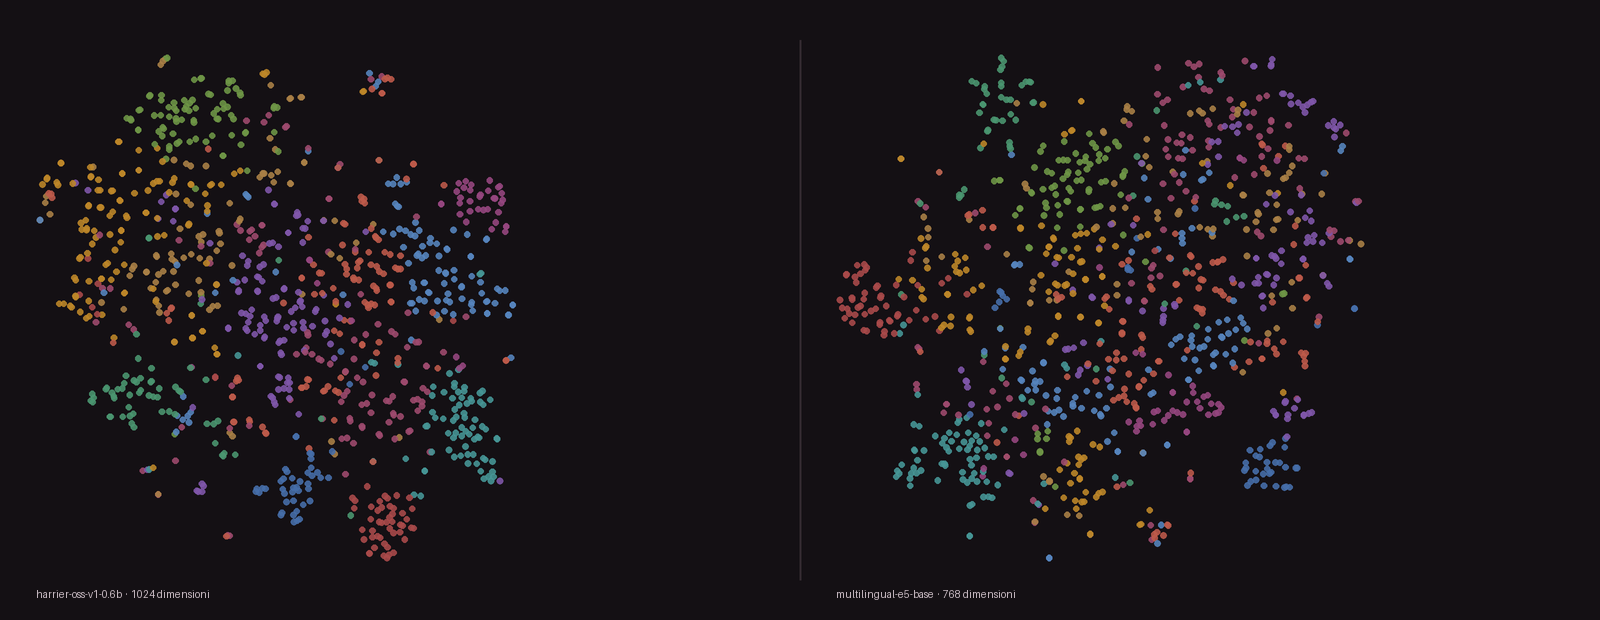
I due spazi vettoriali della galleria qui sopra raccontano un'altra parte della stessa storia: sono gli stessi 1024 ticket visti da due modelli di embedding diversi, con i gruppi calcolati una volta sola sul primo e riusati sul secondo. Dei dieci vicini più simili, i due modelli ne condividono circa tre, il che vuol dire che la scelta del modello di embedding sposta davvero quali schede finiscono in contesto.
Nozioni apprese
- Un confronto vale quanto il suo controllo — se cambiano due cose alla volta, il risultato non dice niente. Tenere fermi dati, modello, prompt e giudice è stata la parte più importante del lavoro, molto prima del codice.
- Il retrieval è il collo di bottiglia, ma non spiega tutto — recuperare quasi sempre la scheda giusta migliora enormemente la fedeltà e pochissimo la correttezza. La risposta finale dipende anche da come il modello legge quello che ha davanti.
- Semantica e parole esatte servono insieme — sulle sigle di dominio il ramo lessicale trova quello che il ramo semantico si perde, e due schede quasi identiche possono differire per un solo verbo.
- In locale si paga in hardware e si guadagna in dati che restano dentro — con dati aziendali reali non è un compromesso, è il requisito.
- Containerizzare separa le responsabilità — aggiungere una pipeline senza toccare quella di un altro è stato possibile perché ognuna vive nella sua immagine, con il frontend che smista le chiamate.
- Misurare costa poco e cambia le conclusioni — ripetere lo stesso benchmark due volte mostra quanto si muovono i numeri da soli, e senza quella ripetizione una differenza piccola sembrerebbe un risultato.